Платформа
Весь цикл работы с данными — в одном месте
Подготовка данных, предиктивное моделирование, 3D-сегментация и дашборды в реальном времени — в одном пакете.

Движок на C и ассемблере
Движок, созданный для работы максимально близко к процессору. Обрабатывает миллиарды строк на обычном оборудовании.

Интерфейс без кода
Визуальные рабочие процессы на весь жизненный цикл данных. Писать код не нужно, но это всегда можно сделать, когда потребуется.

Полный суверенитет данных
Ваши данные остаются у вас. On-premise, частное облако, гибрид или edge — выбор за вами.

Модули
Четыре модуля. Один язык. Созданы, чтобы работать вместе.
Каждый модуль оптимизирован под свою задачу. Все они говорят на одном языке, одинаково требовательны к производительности и изначально совместимы друг с другом.

Anatella
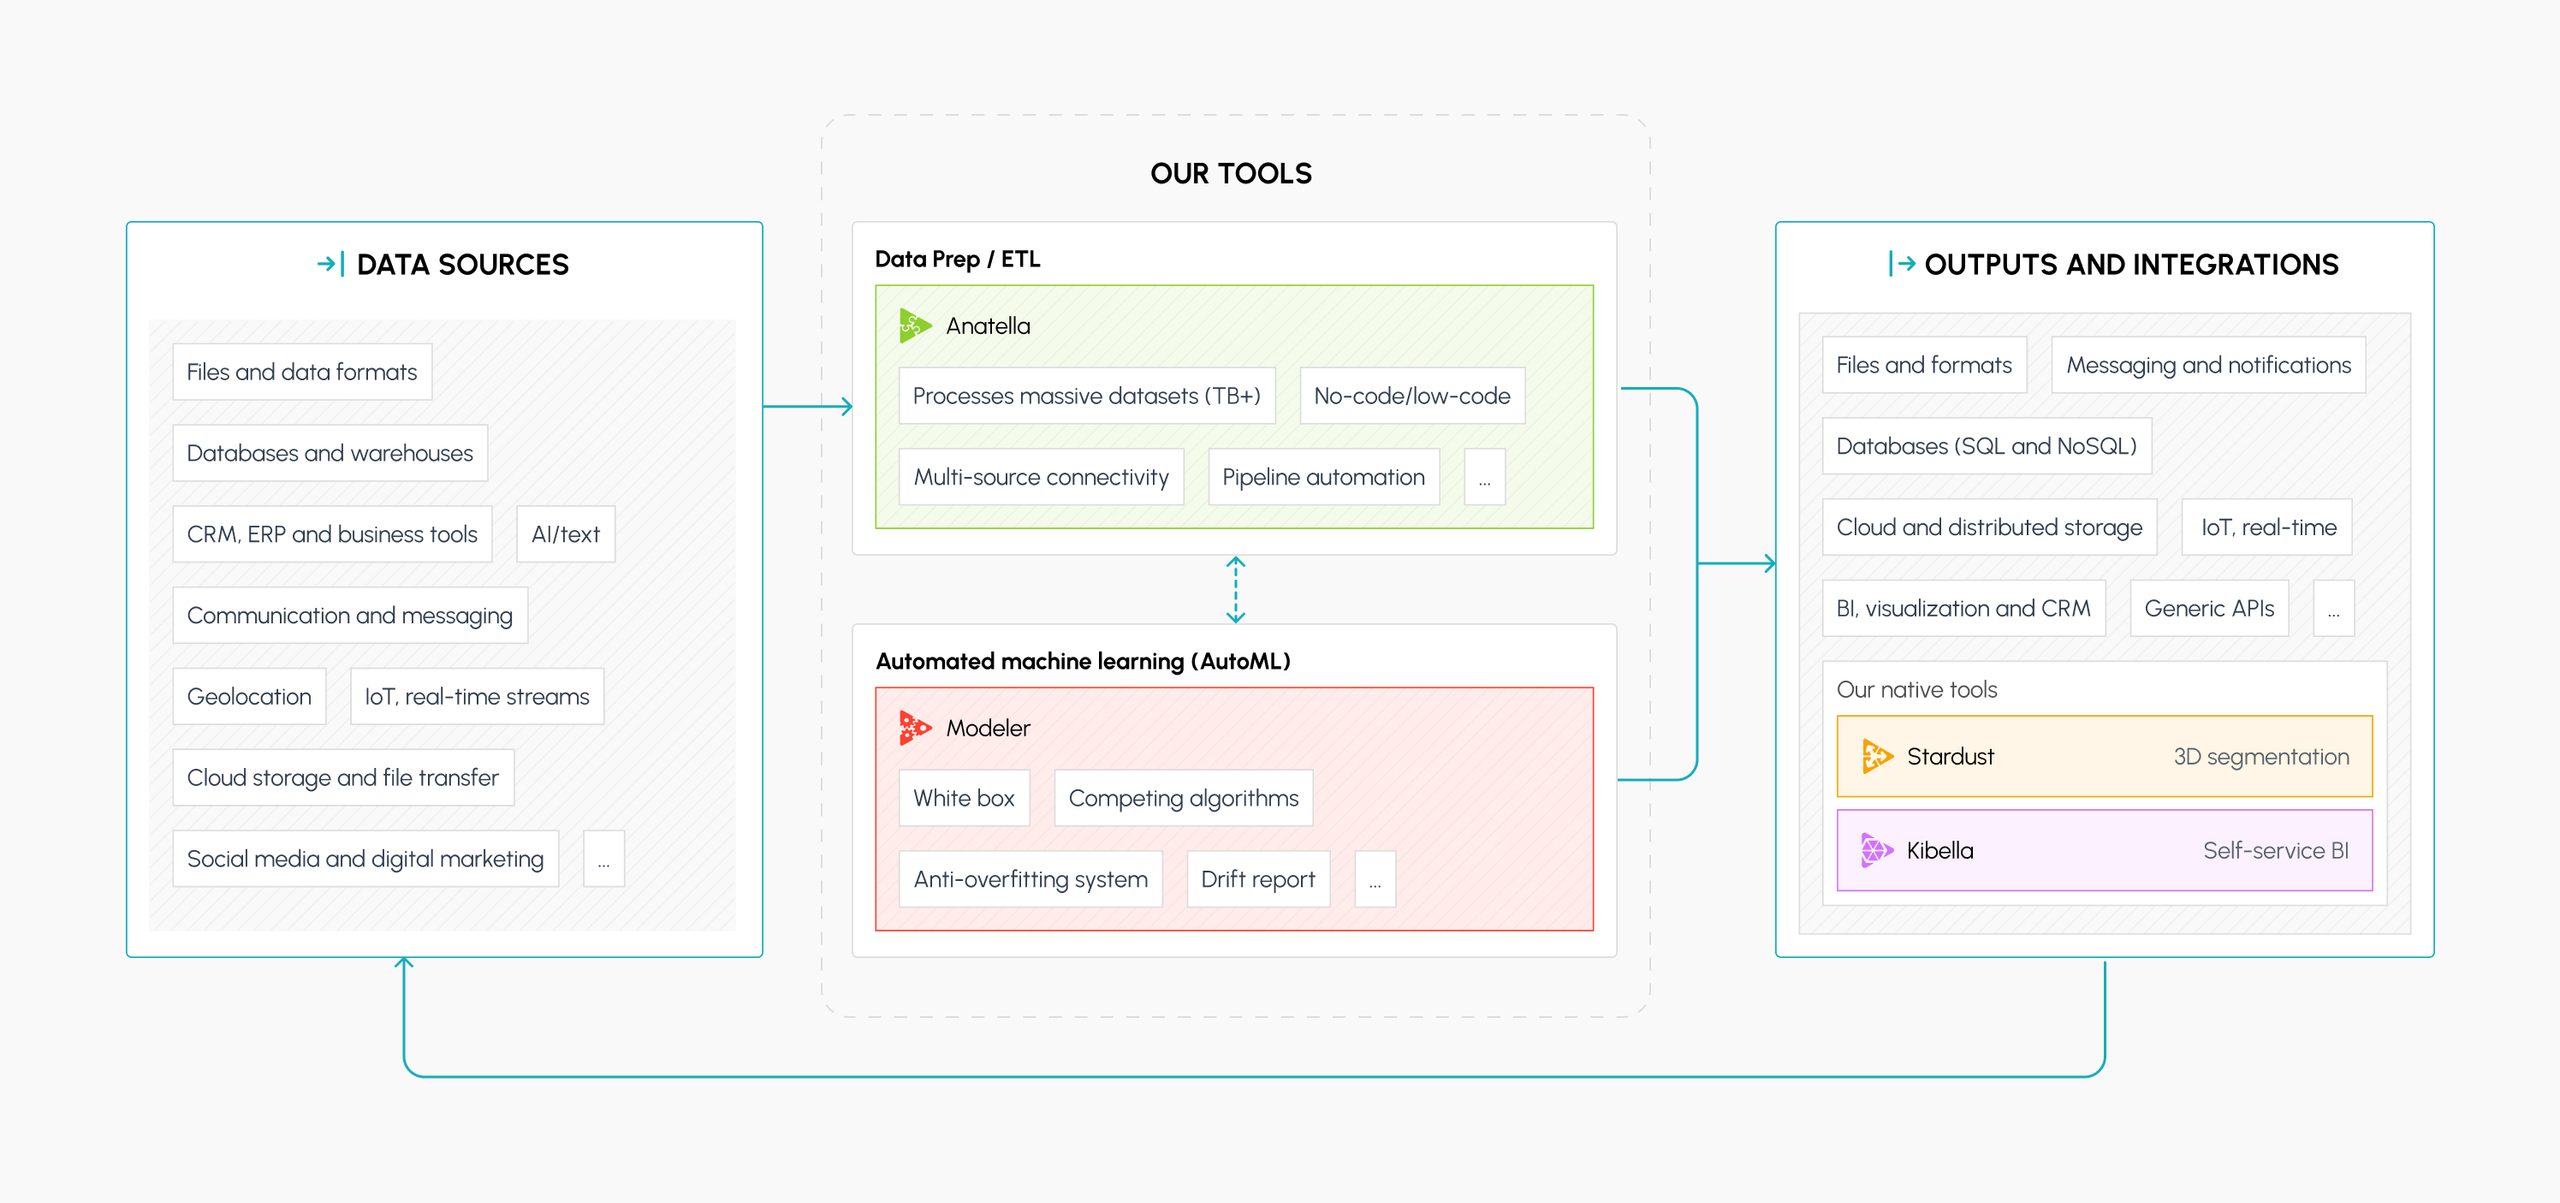
Собирайте, подключайте и готовьте любые данные. На полной скорости.
Anatella — это движок данных пакета TIMi. Он подключается к любому источнику, выполняет сложные преобразования над наборами данных целиком и управляет пайплайнами от начала до конца. И всё это на одной машине.
В чём отличие
Нативное выполнение на C и ассемблере
Никаких слоёв абстракции: оптимизация идёт прямо на уровне процессора.
No-code / low-code
Визуальный редактор рабочих процессов с перетаскиванием и скрипты по желанию (C / JS / R / Python).
Экстремальные объёмы
Миллиарды строк на одном стандартном сервере, без кластера.
Независимость от платформы
Нативно подключается к любому источнику в любой инфраструктуре.
Независимый бенчмарк: в 145 раз быстрее Talend на объёме более 1 млрд строк (IntoTheMinds, 2021).
Anatella с собственным форматом .gel на SSD: 96 секунд против 13 954 секунд у Talend Open Studio на CSV-файле. На CSV-файлах Anatella быстрее в 19 раз. Смотреть график.

Modeler
Прозрачный AutoML в полном масштабе
Modeler — это предиктивный движок пакета TIMi. Он автоматически строит, сравнивает и проверяет предиктивные модели на 100 % ваших данных, и каждое решение можно полностью объяснить.
В чём отличие
Автоматический отбор переменных
Из тысяч кандидатов остаются только значимые переменные: 657 предикторов в продакшене в модели оттока MTN.
Алгоритмы соревнуются — решает математика
Несколько моделей сравниваются между собой, и лучшая выбирается по статистическим критериям, а не наугад.
White-box даже в большом масштабе
Каждая переменная объяснена, каждый вес задокументирован. Проверено на модели финансового риска с 24 000 переменных и точностью 98 % (BNP Paribas).
Встроенный Drift Report
Качество моделей отслеживается с течением времени, так что деградация будет замечена раньше, чем отразится на ваших KPI.

Stardust
3D-сегментация
Stardust позволяет визуально исследовать сложные наборы данных с помощью интерактивной 3D-кластеризации. Находите скрытые структуры. Выявляйте выбросы.

Kibella
BI самообслуживания
Kibella предлагает быстрые встроенные дашборды, подключённые напрямую к движку TIMi. Никакой внешней синхронизации. Никаких дубликатов данных.

Marvim
Управление данными
Marvim отображает и документирует движение ваших данных в любом инструменте. С Anatella документация создаётся автоматически.
Работает где угодно
Ваша инфраструктура. Ваши правила. Ваш масштаб.
Любой объём. Любая скорость. Любые форматы. TIMi подстраивается под вашу среду, а не наоборот. Никакой привязки к вендору. Никогда.
On-premise
TIMi работает на ваших серверах, в вашем дата-центре, на вашем оборудовании. Полный контроль, вы ни от кого не зависите. Установка занимает меньше минуты.
Изолированная среда
Для сред, физически изолированных от сети (air gap). Исходящие подключения не нужны. Полная операционная независимость.
Частное облако
Разверните TIMi в частном облаке, которое контролируете вы. Тот же движок, та же производительность, и среду вы ни с кем не делите.
Гибрид
Сочетайте on-premise, облако и edge. Данные перемещаются только тогда, когда вы так решили.
Edge
Запускайте TIMi рядом с источником данных. Всё обрабатывается на месте, без пересылки в удалённый дата-центр и обратно.
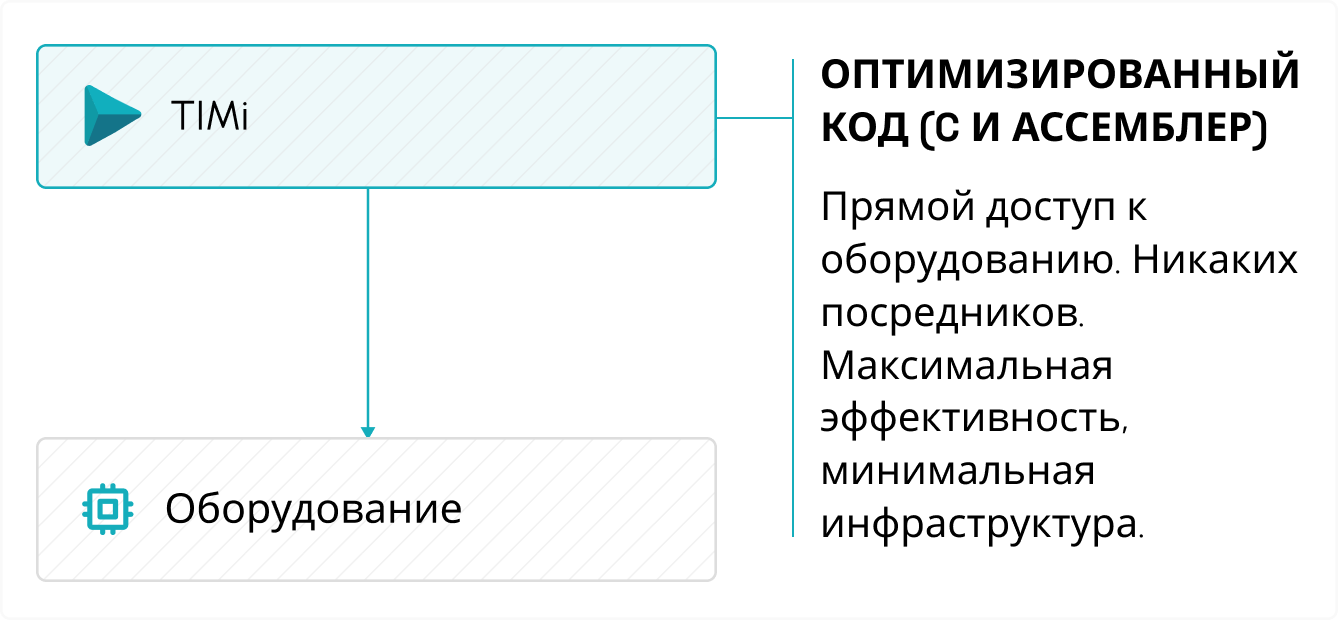
СКРЫТАЯ ЦЕНА СЛОЁВ АБСТРАКЦИИ
Производительность даёт код, а не железо.
Традиционный подход
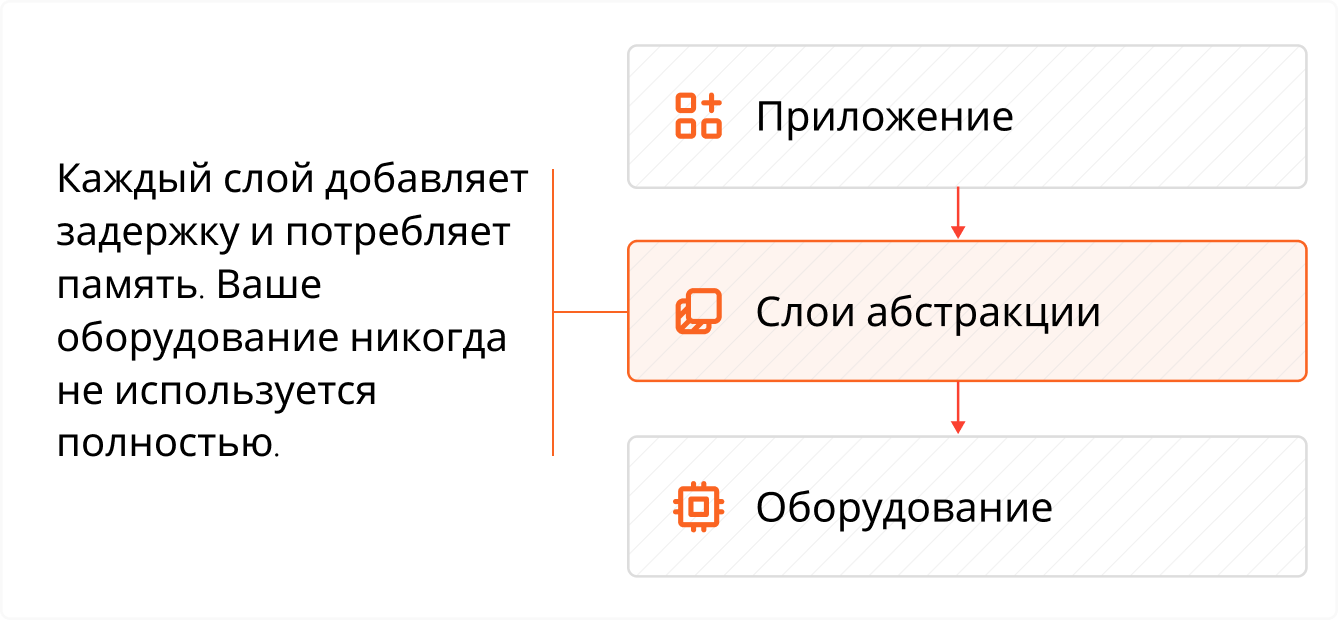
Наш подход
Результаты клиентов
Вся ценность ваших данных — без компромиссов.
94 % отказов предсказано
за 30 минут до сбоя
Предиктивное обслуживание развёрнуто менее чем за неделю на аэрокосмической производственной линии, работающей круглосуточно.
150 млрд транзакций каждый месяц
Snype подтверждает данные о трафике, выручке и мошенничестве в национальной телеком-сети. И всё это на одном стандартном сервере.
Более 1800 новорождённых спасают каждый год
Grupo Sura прогнозирует неонатальные осложнения за срок до 6 месяцев, с точностью более 98 %.
Бюджет RSA: прогноз с точностью 97,2 %
Полный суверенитет данных, без дополнительной инфраструктуры. А методику можно применить к другим бюджетам и пособиям.
Биллинг: производительность выросла на 95 %
Каждый месяц Codensa обрабатывает 1,8 млрд точек данных IoT в реальном времени на одном сервере.
Риск дефолта: точность оценки 98 %
BNP Paribas выявляет компании с риском банкротства по 24 000 переменных финансовой динамики.
Отзывы
Что говорят наши клиенты
«Производительность поражает даже на ноутбуке начального уровня. Это намного быстрее, чем MS Query на сопоставимой машине».
Бернард Д. — старший финансовый консультант
«Anatella (ETL) и Modeler обрабатывают большие объёмы данных гораздо быстрее большинства конкурентов и при этом почти не расходуют память».
Дэниел М. — статистик и разработчик программного обеспечения
«За 22 года в профессии, из них 10 с TIMi, я мог бы написать целую книгу о том, что TIMi действительно дал мне по сравнению с конкурентами».
Артур Г. — дата-сайентист
FAQ
Частые вопросы.
Что такое платформа TIMi?
TIMi: единая аналитическая платформа, охватывающая подготовку данных, прогнозное моделирование, 3D-сегментацию, BI самообслуживания и управление данными. Её движок написан на C и ассемблере и работает на вашей собственной инфраструктуре.
Какие модули входят в платформу?
Anatella для подготовки данных и конвейеров, Modeler для AutoML по принципу белого ящика, Stardust для 3D-сегментации, Kibella для BI самообслуживания и Marvim для управления данными. Модули используют один язык и изначально совместимы друг с другом.
Где можно развернуть TIMi?
Локально (on-premise), в изолированной среде, в частном облаке, в гибридной схеме или на периферии (edge). Ваши данные перемещаются только по вашему решению.
Нужен ли кластер для обработки больших объёмов?
Нет. TIMi обрабатывает миллиарды строк на одном стандартном сервере, а горизонтальное масштабирование возможно без переписывания кода. Например, Snype сертифицирует трафик, доходы и мошенничество в национальной телекоммуникационной сети, 150 миллиардов транзакций в месяц, на одном стандартном сервере.
Можно ли объяснить модели?
Да. Modeler по своей конструкции работает по принципу белого ящика: каждая выбранная переменная объясняется, а каждое решение прослеживается до данных. Это поддерживает требования к прозрачности AI Act и GDPR.
К каким источникам данных может подключаться TIMi?
Базы данных, файлы, облачные хранилища и бизнес-приложения. Anatella подключается более чем к 80 источникам и работает с полным набором данных, а не с выборкой.
Зависит ли TIMi от Java или другой среды выполнения?
Нет. TIMi: скомпилированный код на C и ассемблере, без JVM и без слоя интерпретации между вашими данными и оборудованием.
Как попробовать TIMi?
Скачайте бесплатную пробную версию и запустите TIMi на своих данных или запросите живую демонстрацию. TIMi бесплатен для НКО и академических исследований.
УБЕДИТЕСЬ САМИ
Не верьте нам на слово.
Запустите TIMi на собственных данных в бесплатной пробной версии или закажите живую демонстрацию.

